Next.js Git Blog (3): 마크다운 포스팅 기능 구현
목차
소개#
페이지 전환이 가능해졌으니, 레이아웃을 구성하여 블로그의 외형을 만들고자한다.
기본적인 레이아웃 구성을 아래와 같이 설계했는데,
- Header: 사이트 로고 및 네비게이션 바 (Navigation bar)
- Main: 페이지의 핵심 콘텐츠 (글 목록 또는 상세 내용)
- Footer: 저작권 정보 및 SNS 링크
레이아웃이나 템플릿 자체를 만드는 것은 익숙한 작업이라 금방 하겠으나, "정적 사이트니까 모든 내용을 직접 컴포넌트로 만들어야하나" 의문이었다.
확인 결과, 비슷한 방식을 사용하는 많은 블로그에서 유지보수와 작성 편의상의 이유로 마크다운 파일을 활용한다는 것을 알게 되었다.
마크다운(Markdown) 사용의 장점#
마크다운 파일을 사용하면 아래와 같은 장점이 있다고 한다.
- 콘텐츠 분리: UI 로직과 글 내용을 분리하여 관리할 수 있다. 이 부분이 무척 매력적이다.
- 작성 편의성: 별도의 HTML 태그 없이, 서식 있는 글을 빠르게 작성할 수 있다.
- 라이브러리 활용: 마크다운을 HTML로 파싱해주는 라이브러리들이 이미 잘 배포되어 있다.
마크다운 파싱 로직 구현#
라이브러리를 활용해 로컬에 저장된 마크다운 파일을 읽어오고, 이를 HTML로 변환하는 과정을 구현해 보겠다.
1. 라이브러리 설치
먼저 사용 중인 패키지 매니저를 통해 마크다운 처리에 필요한 라이브러리들을 설치한다.
pnpm install gray-matter remark remark-html2. 스크립트 작성
마크다운 파일에서 데이터(Front-matter) 와 본문(Content) 을 분리하여 반환하는 함수를 작성한다.
// contentRoot: 마크다운 파일이 위치한 실제 물리 경로
const contentRoot = path.join(process.cwd(), 'contents');

export const getMarkDown = async (id: string) => {
	const fullPath = path.join(contentRoot, `${id}.md`);
	const fileContents = fs.readFileSync(fullPath, 'utf8');

	// 1. gray-matter를 이용해 메타 데이터와 본문 분리
	const { data, content } = matter(fileContents);

	// 2. remark를 이용해 마크다운 본문을 HTML 스트링으로 변환
	const processedContent = await remark().use(html).process(content);
	const contentHtml = processedContent.toString();

	return {
		id,
		contentHtml,
		title: data.title,
		date: data.date,
	};
};
📌 사용된 라이브러리 역할
여기서 사용된 라이브러리의 역할은 다음과 같다
- gray-matter: 마크다운 상단의
---영역(제목, 날짜 등)을 객체 형태로 파싱- remark: 마크다운을 분석하는 핵심 라이브러리
- remark-html:
remark가 해석한 마크다운 구조를 HTML 태그로 변환
문제점: 정적 라우팅의 한계#
일반적으로 블로그라면 글마다 고유한 주소가 존재한다. https://htbae.github.io/web/practice 같은 방식을 예로들 수 있다.
하지만 지난 글에서 살펴봤듯이, Next.js의 기본적인 정적 라우팅 방식으로는 모든 포스트에 대응하는 실제 디렉토리와 파일(practice.tsx)을 일일이 생성해야한다.
마크다운으로 글을 쓴다 해도, 결국 매번 컴포넌트 파일까지 만들어야 하는 번거로움이 있다.
src
└── pages
    └── web
        └── practice.tsx
해결 방법: 동적 라우팅(Dynamic Routes)#
1. Next.js의 동적 경로 활용
다행히 Next.js는 파일 이름을 대괄호로 감싸는 방식으로 주소를 동적으로 포괄할 수 있는 기능을 제공한다.
패턴에 맞는 모든 주소를 하나의 컴포넌트에서 처리할 수 있다.
[section]/[slug].tsx:/[카테고리]/[글-제목][section]/index.tsx:/[카테고리]
2. 파일 시스템 기반 데이터 바인딩
URL에서 추출한 section과 slug를 이용해 실제 파일을 찾아오는 로직을 보강한다.
// 마크다운 파일이 위치한 실제 경로를 정의
const contentRoot = path.join(process.cwd(), 'contents');

// 모든 카테고리(디렉토리명) 가져오기
export const getAllSections = (): string[] => {
	if (!fs.existsSync(contentRoot)) return [];

	return fs
		.readdirSync(contentRoot, { withFileTypes: true })
		.filter((entry) => entry.isDirectory() && !entry.name.startsWith('.'))
		.map((entry) => entry.name);
};

// 특정 카테고리 내 모든 글(파일명) 가져오기
export const getAllSlugs = (section: string): string[] => {
	const sectionPath = path.join(contentRoot, section);
	if (!fs.existsSync(sectionPath)) return [];

	return fs
		.readdirSync(sectionPath)
		.filter((file) => file.endsWith('.md'))
		.sort((a, b) => b.localeCompare(a))
		.map((file) => file.replace(/\.md$/, ''));
};

export const getMarkDown = async (section: string, slug: string) => {
	const fullPath = path.join(contentRoot, section, `${slug}.md`);
	const fileContents = fs.readFileSync(fullPath, 'utf8');

	// 1. gray-matter로 데이터(front matter)와 본문을 분리
	const { data, content } = matter(fileContents);

	// 2. 마크다운 본문을 HTML로 변환
	const processedContent = await remark().use(html).process(content);
	const contentHtml = processedContent.toString();

	return {
		section,
		slug,
		contentHtml,
		title: data.title,
		date: data.date,
	};
};
3. 상세 페이지 구현([slug].tsx)
getStaticPaths와 getStaticProps를 조합하여 빌드 타임에 모든 마크다운 페이지를 미리 생성한다.
export const getStaticPaths: GetStaticPaths = async () => {
	const sections = getAllSections();
	// 모든 섹션의 모든 슬러그를 조합하여 경로 생성
	const paths = sections.flatMap((section) =>
		getAllSlugs(section).map((slug) => ({
			params: { section, slug },
		})),
	);

	return { paths, fallback: false };
};

export const getStaticProps: GetStaticProps = async ({ params }) => {
	const { section, slug } = params as { section: string; slug: string };

	try {
		const post = await getMarkDown(section, slug);
		return { props: { ...post, section } };
	} catch (err) {
		return { notFound: true };
	}
};

const SlugPage = ({ title, date, contentHtml }: SlugPageProps) => {
	return (
		<article>
			<h1>{title}</h1>
			<time>{date}</time>
			<hr />
			{/* 파싱된 HTML을 렌더링 */}
			<div dangerouslySetInnerHTML={{ __html: contentHtml }} />
		</article>
	);
};
이제 contents/web/my-post.md 파일을 생성하기만 하면, 별도의 컴포넌트 생성 없이도 localhost:3000/web/my-post 주소로
정상적으로 본문 내용이 나타나는 것을 볼 수 있다.
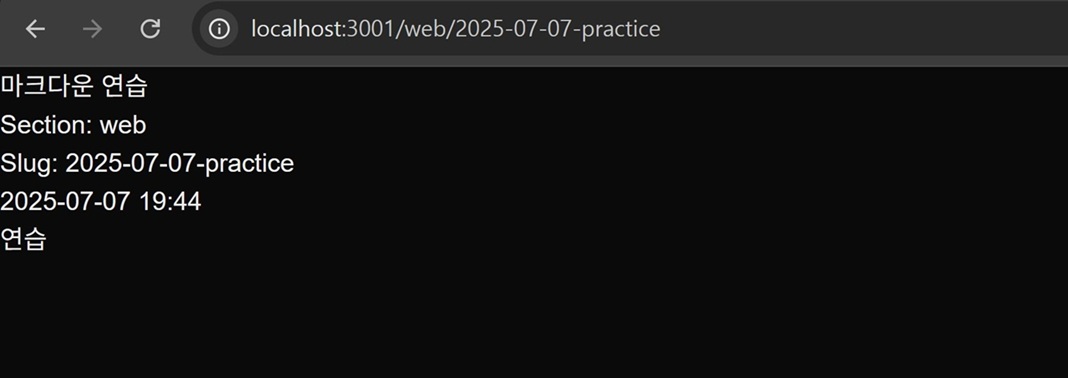 그림 1. 동적으로 마크다운 파일 내용이 정상적으로 나타난 모습
마무리#
마크다운 데이터 파싱부터 동적 라우팅을 이용한 렌더링까지, Next.js 블로그의 핵심 기능을 모두 알아보았다.
처음 접해본 getStaticPaths와 getStaticProps가 다소 생소하기도 했지만, 빌드 타임에 정적 파일을 생성하는 Next.js의 메커니즘을 이해하고 나니 그 역할이 명확해진 것 같다.
이제 준비는 끝났으니, 앞으로는 UI 개선과 부가 기능 추가에 집중하며 블로그를 점진적으로 발전시켜 나가면 좋을 것 같다.