Nextflow 기초: 개념 및 특징 정리
목차
소개#
회사에서 파이프라인 작업을 다루는 서비스가 많아짐에 따라, 이를 더 효율적이고 체계적으로 관리할 방법이 필요해졌다. 이를 위해 학습하게 된 Nextflow에 대한 내용을 정리해 보고자 한다.
Nextflow는 데이터 집약적인 워크플로우를 효율적으로 구축하고 관리하기 위한 오픈소스 워크플로우 프레임워크다.
복잡한 데이터 분석 파이프라인을 작성할 때, 각 단계를 연결하고 실행하는 과정을 자동화해준다. 생물정보학 분야에서 많이 사용되었으며, 현재는 대규모 데이터 처리가 필요한 여러 분야에서 사용되고 있다고 한다.
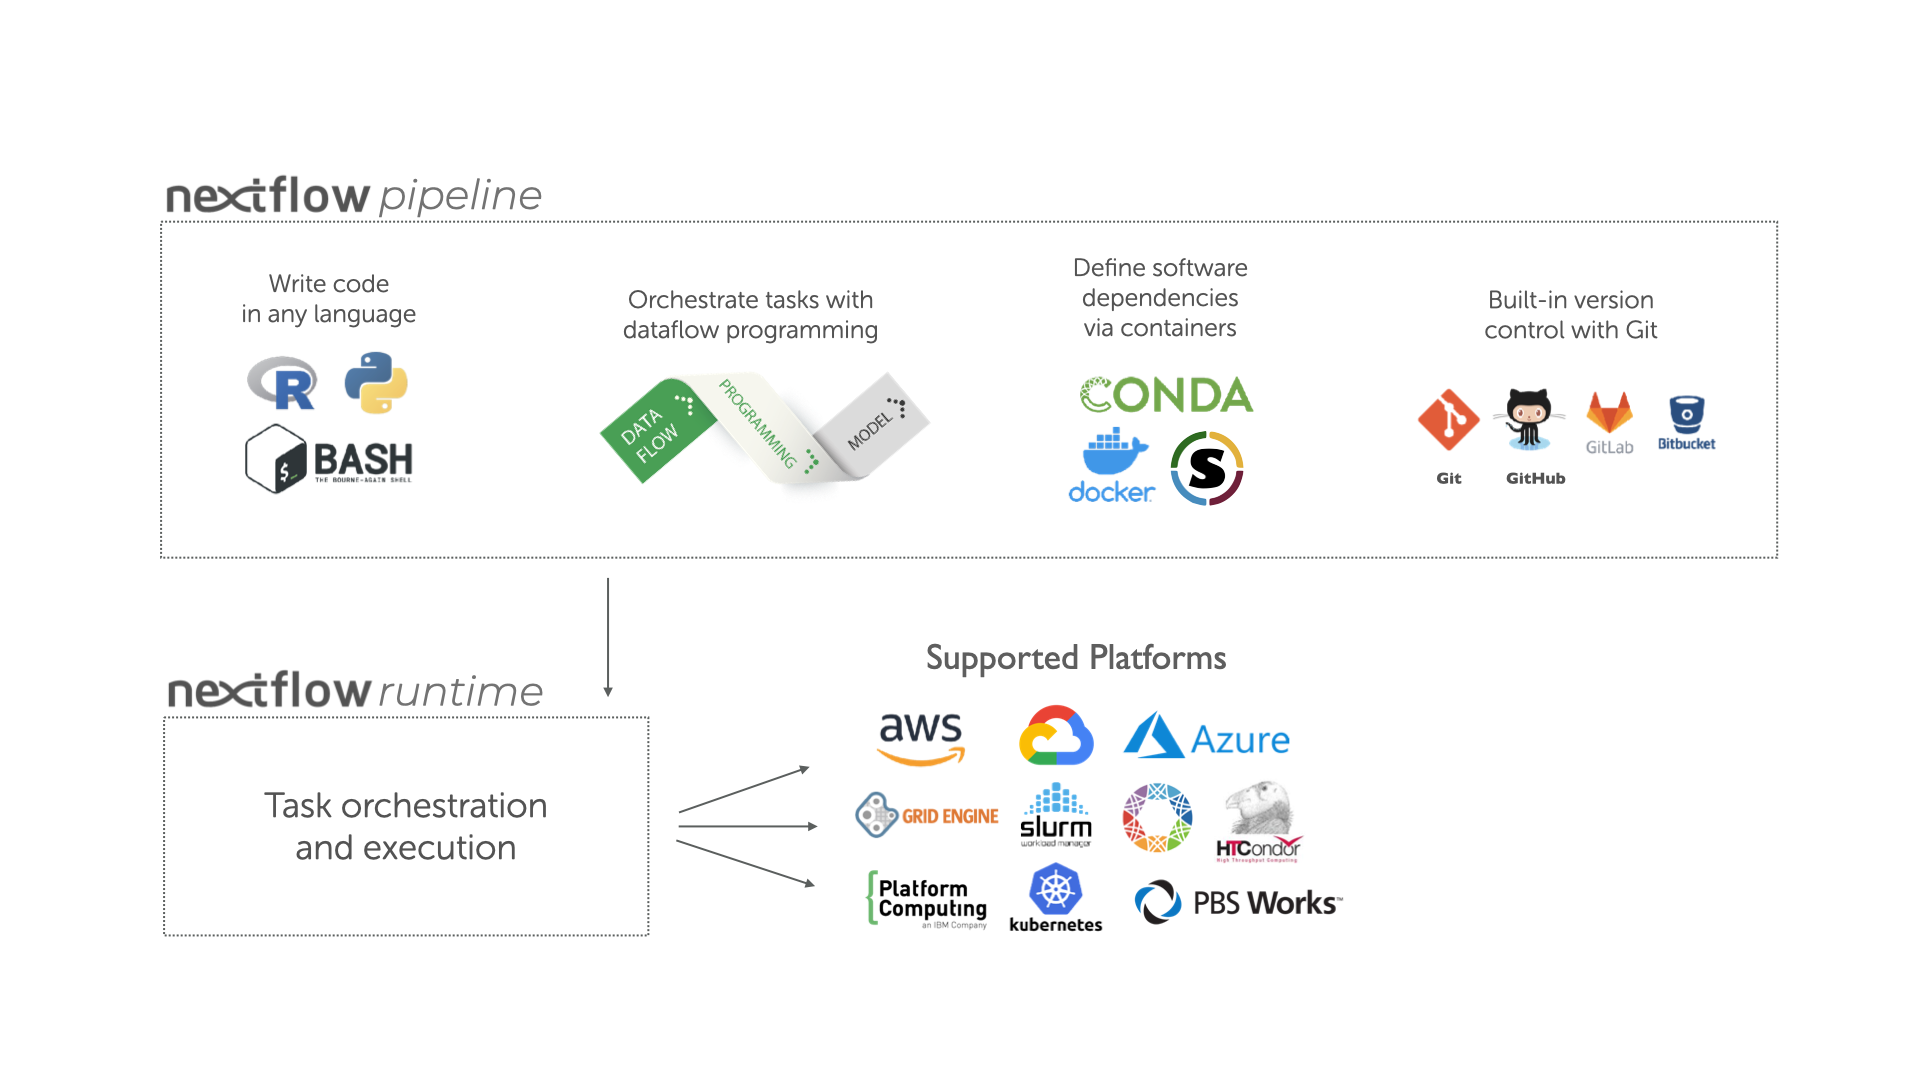 그림 1. Nextflow가 구성되는 전반적인 아키텍처(출처: Nextflow.io)
주요 특징#
- 재현성 (Reproducibility)
- Docker, Singularity, Conda 등과 완벽하게 통합된다. 환경 자체를 컨테이너화하여 어디서든 동일한 결과를 보장해준다.
- 이식성 (Portability)
- 로컬 PC에서 작성한 코드를 수정 없이 다양한 환경(AWS Batch, Google Cloud Life Sciences, Kubernetes 등)으로 배포할 수 있다.
- Tip: Nextflow가 강력한 이식성을 갖는 이유는 Groovy(JVM 기반) 언어를 바탕으로 설계되었기 때문이다.
- 병렬 처리 (Parallelization)
- 각 단계가 독립적으로 실행될 수 있다면, Nextflow가 알아서 병렬로 처리하여 작업의 효율을 높인다.
- 오류 복구 (Error Recovery)
- 특정 단계에서 에러가 나면, 처음부터 다시 시작할 필요가 없다.
-resume옵션을 통해 성공한 단계는 캐싱된 결과를 쓰고, 실패한 부분부터 재시작할 수 있다.
- 특정 단계에서 에러가 나면, 처음부터 다시 시작할 필요가 없다.
Process와 Channel#
Nextflow은 크게 아래 두 가지의 핵심 개념이 있다.
- Channel: 프로세스 사이에서 데이터를 주고받는 통로. 한 프로세스의 출력이 채널을 통해 다음 프로세스의 입력으로 들어간다.
- Process: 독립적으로 실행되는 작업 단위(스크립트 실행, 데이터 가공 등)
Dataflow Programming: 데이터가 채널을 통해 들어오는 즉시 프로세스가 실행되는 방식으로, 실행 순서가 아닌 데이터 흐름에 따라 전체 워크플로우가 제어된다.
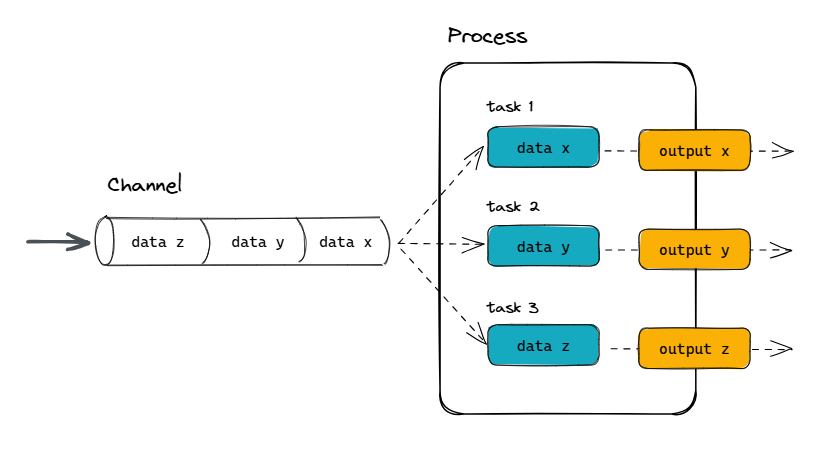 그림 2. 데이터가 채널을 통해 흘러가 프로세스를 실행시키는 모습(출처: Nextflow.io)
Nextflow 설치#
설치는 생각보다 몹시 간단하다. 기본적으로 Nextflow는 POSIX(Linux/macOS) 환경을 타겟으로 설계되었기 때문에, Windows 환경에선 WSL2(Windows Subsystem for Linux) 등을 사용하여 설치할 수 있다.
참고로 Nextflow는 Groovy 기반이기 때문에 JRE(Java Runtime Environment) 를 필요로 하며, 현재 최소 Java 17 이상의 버전이 필요하다.
설치 명령어는 아래와 같다:
# 설치 스크립트 실행 및 실행 권한 부여
curl -s https://get.nextflow.io | bash

# 2. 실행 권한 부여 (필요 시)
chmod +x nextflow

# 명령어를 통해 설치가 정상적으로 되었는지 확인
./nextflow info
설치된
nextflow파일을/usr/local/bin/등 시스템 경로(PATH)로 옮겨두면, 어느 디렉토리에서든./없이 바로nextflow명령어를 사용할 수 있어 편리하다.
마무리#
Nextflow는 **"인프라에 구애받지 않는 환경"**을 제공한다. 복잡한 종속성 관리와 병렬 처리에 고생했다면, Nextflow를 활용하는 것도 좋은 방법인 것 같다.
더 자세한 내용이나 최신 업데이트 사항은 아래 공식 홈페이지를 통해 확인할 수 있다.
- Nextflow 공식 홈페이지: https://www.nextflow.io/
- Nextflow 문서(Docs): https://www.nextflow.io/docs/latest/index.html
다음 글에서는 실제로 간단한 파이프라인을 실행하는 방법에 대해 살펴보도록 하겠다.