Nextflow 기초: 채널(Channel)
목차
소개#
채널(Channel) 은 Nextflow 데이터 흐름(Dataflow)을 담당하는 핵심 개념이다. 프로세스 간 데이터를 전달하는 통로로, Nextflow 환경에서는 모든 프로세스가 독립적으로 실행되기 때문에, 이 채널을 통해 데이터를 주고받으며 전체 워크플로우의 순서를 제어할 수 있게 된다.
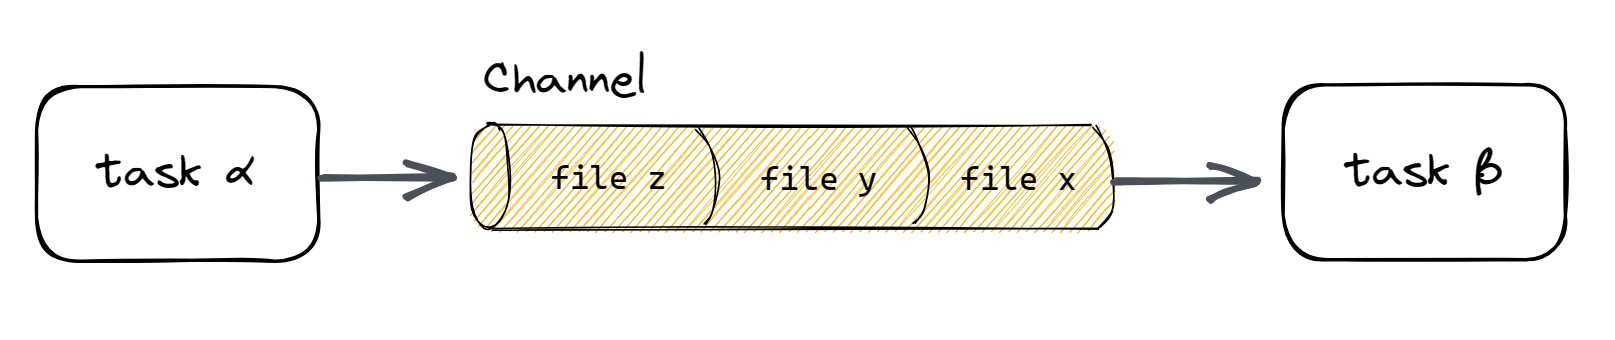 그림 1. 프로세스 간 데이터를 전달하는 통로(출처: Nextflow.io)
주요 특징#
- 비동기 처리: 채널을 통해 데이터가 들어오는 즉시 관련 프로세스가 실행된다.
- FIFO (First-In, First-Out): 기본적으로 먼저 채널에 들어간 데이터가 먼저 나온다.
- 일회성 & 재사용성: 채널의 종류에 따라 데이터를 한 번만 소모할 수도 있고, 여러 번 참조할 수도 있다.
채널의 종류#
Nextflow의 채널은 크게 Queue Channel과 Value Channel로 볼 수 있다.
Queue Channel
- 일회성(1:1 연결)
- 파일 리스트, 개별 샘플 데이터 전달
- 데이터를 하나씩 꺼내 쓰면 사라짐
Value Channel
- 재사용 가능(1:N 연결)
- 설정값 등 공통 데이터 전달
- 프로세스가 몇 번을 실행되도 값을 유지
채널 생성#
채널을 만드는 방법은 아래와 같다:
Channel.of
특정 값을 나열하여 큐 채널을 생성한다.
ch = Channel.of( 1, 2, 3 )
ch.view { "Value: $it" }
Channel.fromPath
파일 경로를 기반으로 채널을 생성한다.
// 특정 경로의 fastq 파일들을 채널로 로드
reads_ch = Channel.fromPath( 'data/samples/*.fastq' )
Channel.value
단일 값을 가지며, 여러 번 호출해도 소멸되지 않는 밸류 채널을 생성한다.
ref_ch = Channel.value( 'reference.fasta' )그럼 이들은 언제 쓰일까?#
Nextflow 파이프라인을 짤 때 "어떤 채널을 쓸 것인가"는 데이터의 성격과 병렬 처리 방식에 따라 결정된다.
-
Queue Channel을 사용하는 경우: 병렬 처리가 필요할 때
데이터가 독립적인 단위(Sample 1, Sample 2...)로 나뉘어 있고, 각 데이터를 동시에(Parallel) 처리해야 한다면 Queue Channel을 사용한다. -
Value Channel을 사용하는 경우: 모든 프로세스가 공유해야 할 때
모든 병렬 작업에 공통으로 적용되어야 하거나, 작업이 반복되어도 사라지면 안 되는 데이터는 Value Channel로 선언해야 한다.
하지만 실제 분석에서는 두 채널을 혼합해서 사용하는 경우가 대부분이다. (Mixing channels)
process ALIGN {
    input:
    path(sample_file) from reads_ch  // Queue: 샘플마다 하나씩 소모
    path(ref_file) from ref_ch       // Value: 모든 샘플이 공유 (계속 남아있음)

    script:
    """
    aligner --input $sample_file --ref $ref_file
    """
}마무리#
다음 글에선 다른 핵심 개념인 프로세스(Proce)에 대해 살펴보도록 하겠다.